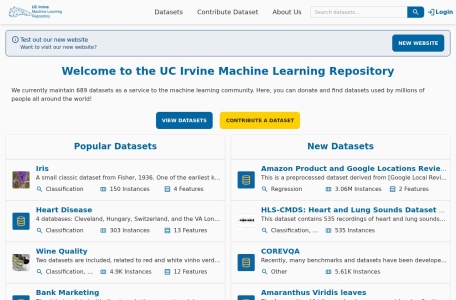



一、网站简介
UCI Machine Learning Repository(加州大学欧文分校机器学习库)是机器学习领域历史最悠久、引用次数最多的开源数据集平台,由加州大学欧文分校于1987年创建。平台收录了超过650个精心整理的标准数据集,涵盖分类、回归、聚类、推荐系统等多种任务类型。每个数据集都配有详细的元数据描述,包括属性说明、缺失值处理建议和相关参考文献。UCI 数据集已成为机器学习算法评估的事实标准,几乎所有经典教材和学术论文都会引用该平台的数据进行实验验证。
二、公司背景
UCI机器学习库由加州大学欧文分校信息与计算机科学学院的 David Aha 与研究生团队于1987年作为FTP档案创建。2007年,Arthur Asuncion 和 David Newman 与马萨诸塞大学阿默斯特分校合作,重新设计了网站界面并扩展了数据规模。该平台被引用超过10万次,入选计算机科学领域被引次数最高的100篇论文之一。目前平台由 UCI 数据科学研究中心持续维护,是学术界公认最权威的机器学习基准数据集来源。
三、核心功能
- 经典基准数据集库:收录了 Iris 鸢尾花、Wine 葡萄酒、Adult 人口收入、Boston Housing 波士顿房价等最具代表性的标准数据集。这些数据集被广泛用于机器学习算法的教学演示和性能对比,是入门的必修课资源。
- 元数据详细描述:每个数据集页面均提供完整的元数据信息,包括数据来源、属性名称及类型、样本数量、特征维度、缺失值情况、类别分布和相关学术论文引用,帮助研究者准确理解数据背景。
- 标准化格式下载:数据集统一以 CSV 或 ARFF(Attribute-Relation File Format)格式提供,可直接导入 Scikit-learn、Weka、R 等主流工具使用,无需额外预处理。
- 按任务类型分类:平台按分类(Classification)、回归(Regression)、聚类(Clustering)、时序(Time-Series)等任务类型对数据集进行归类,用户可根据研究需求快速定位适合的数据。
- 新数据集提交通道:研究者可以向平台提交自己整理的高质量数据集,经审核后公开发布并获得专属 DOI,便于其他研究者引用和复现成果。
四、网站特点
- 学术权威性极高:UCI 数据集已成为机器学习领域的「标准试金石」,几乎所有新算法的性能评估都会在 UCI 数据集上进行。引用 UCI 数据集意味着结果的可比性和可信度得到保障。
- 简洁纯粹无干扰:网站界面极简,没有任何广告或商业推广,专注于数据集的呈现和下载。用户无需注册即可直接下载全部数据。
- 数据质量经过严格审核:每个数据集在收录前都经过基本质量检查,包括一致性验证、异常值检测和元数据完整性审查,确保研究结果的可靠性。
- 教学友好:数据集规模适中,大多在几千到几万条样本之间,不会因为数据过大而让初学者感到无从下手,非常适合课堂演示和自学练习。
五、适用人群
- 机器学习初学者:使用 Iris、Wine 等经典小数据集入门,在熟悉的基准上练习分类、聚类等基础算法。
- 算法研究者:在 UCI 标准数据集上测试新提出的算法,与文献中的已有结果进行公平对比。
- 高校教师:为机器学习课程挑选合适的教学案例数据集,让学生在实践中理解算法原理。
- 论文作者:引用 UCI 数据集作为实验基准,确保结果的可复现性和学术规范。
六、应用场景
- 算法教学演示:教师在课堂上使用 Iris 数据集讲解 KNN 分类算法,学生通过三个品种鸢尾花的四个特征(花瓣长宽、花萼长宽)直观理解特征空间与分类边界。
- 论文实验基准:研究者在提出一种新的集成学习算法后,在 UCI 的 Adult、Wine、Car Evaluation 等10个标准数据集上与 XGBoost、Random Forest 等基线方法进行全面对比。
- 面试准备练习:数据科学求职者在 UCI 上挑选数据集进行端到端的分析项目练习,从数据清洗、特征工程到模型调优,形成完整的作品集。
- 开源库功能测试:开发者在发布新的机器学习工具库时,使用 UCI 数据集编写示例代码和单元测试,确保 API 的通用性和稳定性。
七、常见问题(FAQ)
Q:国内能否直接访问 UCI 机器学习库?
A:可以。UCI 机器学习库属于加州大学教育机构网站,在国内网络环境下可以正常访问和数据下载,速度通常较为理想。
Q:UCI 数据集可以用于商业项目吗?
A:大多数 UCI 数据集采用开放许可,可用于学术和非商业目的。但部分数据集涉及特定机构的专有数据,在商业环境中使用前建议查看每个数据集页面标注的使用条款,必要时联系数据提供方获取授权。
Q:为什么很多论文都使用 UCI 数据集而不是 Kaggle?
A:UCI 数据集历史更久远(1987年至今),在学术界形成了稳定的引用传统。其数据集规模适中、格式统一、元数据规范,便于进行严格的算法对比实验。Kaggle 数据集虽然丰富,但质量参差不齐且部分数据偏重竞赛性质。
Q:UCI 平台的数据集会更新吗?
A:平台持续接收新数据集提交,每年都有新增。但经典数据集(如 Iris、Adult)的内容一般不会变动,以保证研究结果的可比性。用户可通过网站首页的「Recently Added」栏目查看最新收录的数据集。
八、类似网站
- OpenML:开源机器学习平台,提供数据集、算法和实验的统一管理,强调实验可复现性。
- Kaggle Datasets:全球最大的数据集社区,数据集数量远超UCI但质量控制相对宽松。
- Papers with Code:提供数据集与论文、代码的关联索引,方便查找各任务的SOTA基准。
数据统计
数据评估
本站Eyosc Nav提供的UCI Machine Learning Repository都来源于网络,不保证外部链接的准确性和完整性,同时,对于该外部链接的指向,不由Eyosc Nav实际控制,在2026-05-17 21:42收录时,该网页上的内容,都属于合规合法,后期网页的内容如出现违规,可以直接联系网站管理员进行删除,Eyosc Nav不承担任何责任。


